21世纪经济报道记者孙燕上海报道
今年以来,越来越多芯片厂商将超节点搬上了展台。
大模型参数量从千亿迈向万亿,单芯片性能与显存的物理极限日益临近,单机8卡、多机组网的传统服务器架构已难以承载如此庞大的算力需求。集群间依靠网卡通信所带来的内存带宽瓶颈,正成为横在大模型面前的一堵墙。
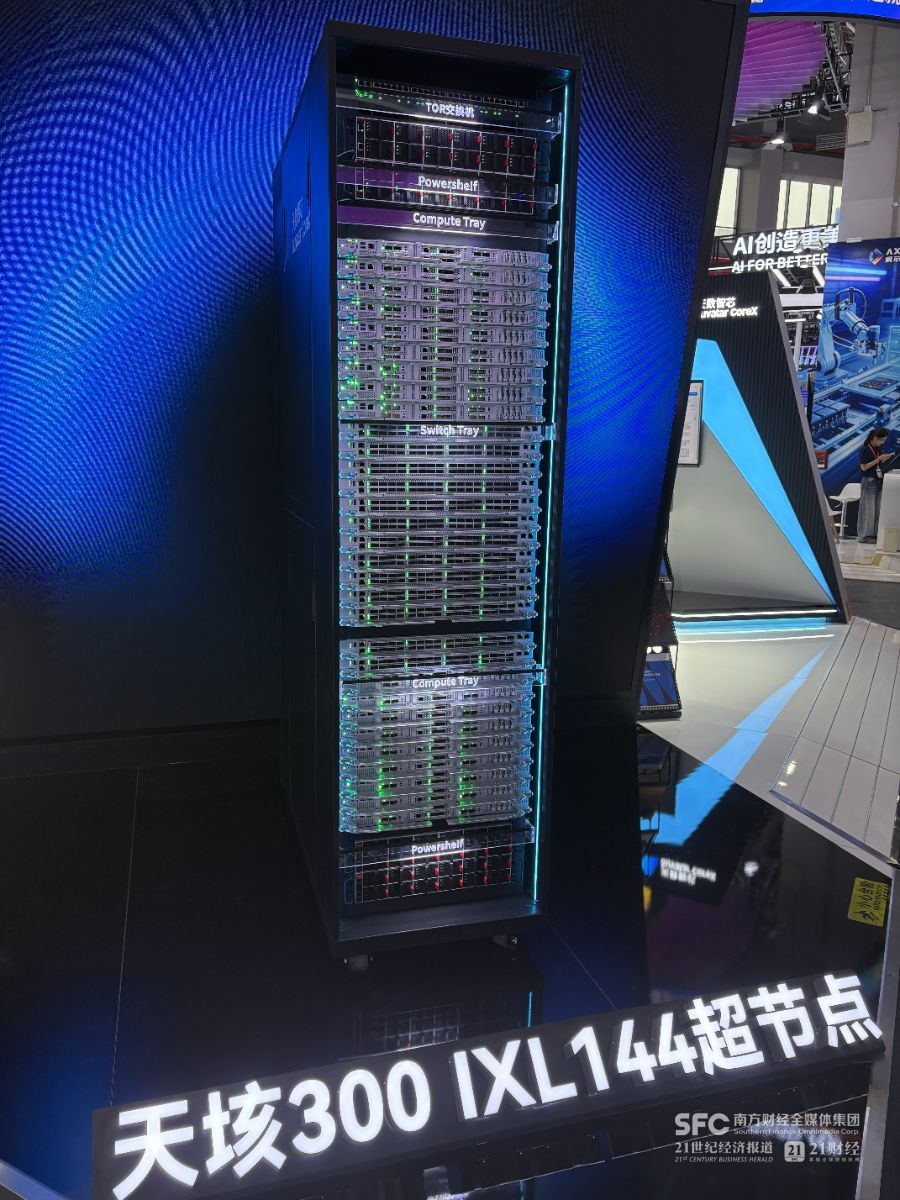
超节点,正是为推倒这堵墙而生。2026工博会上,多家芯片厂商展出了超节点方案:沐曦股份带来了曦景S600超节点,单机柜集成64卡全互连;天数智芯首次展出天垓300 IXL144,单柜可集成144颗GPU,是业界最高密度的单机柜GPU超节点。
“以前是一台服务器装8张卡,即所谓‘单节点’;单节点不够用了,就沿着传统数据中心的做法把多台服务器连成集群,但集群间通信的效率难以提升,卡与卡之间的数据交换又成为新的短板。”天数智芯副总裁郭为告诉21世纪经济报道记者,在大模型参数量越来越大的情况下,既要有足够算力,也要让多颗芯片高效协同,超节点更适合承载这类任务。
超节点的出现,为高算力场景下对大显存容量和高效数据交换的需求提供了根本解决方案。
但一个现实问题是:单机柜的超节点集成了上百颗芯片,而芯片本身价格不菲,因此整套系统的采购门槛相当高。
那么,什么样的场景值得为之买单?郭为告诉记者,高并发、超长上下文、需要超大显存的高附加值场景需要超节点。
最典型的场景是Token(词元)工厂。假设要部署一个万亿参数级别的大模型,并支撑数百乃至上千用户的高并发访问,同时还要满足长上下文需求,这就要求系统具备高算力、高效协同和大显存容量三方面的能力。“我们基于144颗GPU的超节点,配备约10.1TB显存,可同时支撑高并发与超长上下文,对于Token工厂或自建大模型服务的客户而言是最佳选择。”
此外,郭为指出,搜索推荐、AI Coding、AI短剧、超长文档分析等场景也需要超节点。“AI Coding是当前最复杂的Token应用之一:它对模型参数量要求极高,同时工程师在高并发场景下往往需要处理数千行代码的超长上下文。面对这样的双重挑战,超节点是最优解。”
这些场景的爆发,正在回答一个悬置已久的问题。“大家常问:建了这么多智算中心、训练了这么多大模型,到底谁来用?这个问题以前很难回答。而今年以来,这个问题可以回答了——因为这些算力能用了,AI Coding、AI短剧、AI短视频等都是靠这些算力支撑起来的。‘算力到底有没有用’这个问题,今年终于有了明确的答案。”郭为表示。
也正因如此,超节点的战场呈现出“小而精”的格局。郭为指出,真正能用超节点的最终用户数量有限,能提供超节点的芯片厂家也就五六家。
当超节点成为大模型时代的算力标配,厂商之间的比拼也悄然收敛到一个共同的焦点——单机柜密度。
这并非偶然:机房空间是有限的,用户真正关心的,是在同样的机房面积里能装下多少算力——谁能在一台标准机柜里集成更多芯片、池化更大显存、提升芯片间的数据交换效率,谁就能交付更高的单位空间产出。
回看演进路径,传统智算中心的标准机柜里是4U服务器,每台搭载8张卡,即便采用30~50kW的高电机柜,最多容纳3~4台服务器,单机柜容量长期停留在24~32卡的量级。随着大模型参数量暴涨、集群间通信效率瓶颈日益凸显,各家厂商相继推出超节点方案,单机柜密度随之跃升至64卡、128卡的新一代水平。
天数智芯则将单机柜密度推高至144颗GPU,创下目前业内单柜密度的最高纪录。近日在云栖大会上,阿里云也展示了磐久AL144 ScaleUp超节点方案,单柜ScaleUp域最大144卡。
谈及144颗GPU背后的密度跃升,郭为告诉记者,能实现如此高的单机柜密度,一方面靠供电——IDC机房经过改造,预留了更大的供电空间;另一方面靠互连——把传统服务器之间通过网卡通信的方式,改为柜内全互连,大幅节省了空间、提升了密度。
然而,用户购买超节点时,芯片成本只是冰山一角。机房改造成本、算法迁移成本、运维成本、存储成本共同构成总拥有成本。
郭为指出,超节点要从技术验证走向规模采购,芯片厂商应帮用户算清三笔账:一是迁移账,已有的模型与代码是否需要推倒重写;二是机房账,是否要为整机柜专门改造供电、承重与散热,乃至新建机房;三是运营账,每百万有效Token的成本能否下降,算力能否按需扩展而不形成闲置。
单看一颗芯片的参数,或是一台机柜的密度,都不足以定义胜负。超节点的价值藏在整个系统的协同之中:上百颗芯片的互连效率、显存池化的规模、供电与散热的支撑能力、机房改造成本的高低,以及部署后能否在同样的空间和电力下产出更多Token,这些环节环环相扣,最终比拼的是系统经济效能。
(文章来源:21世纪经济报道)




