10月6日,OpenAI(美国开放人工智能研究中心)一次性开源了722篇数学成果,引发学术界关注。这些成果来自一个尚未发布的内部模型,涉及大量悬而未决的数学难题,平均每项成果仅消耗约3小时的推理算力。
真正值得关注的,不只是AI又解出了多少道题,而是AI产出答案的速度,正在超过人类理解和验证答案的速度。难怪有学者感叹,这一规模“既令人惊叹,又令人沮丧”,其中不乏学者主张给AI“踩刹车”,把学术研究重新交还给数学家。
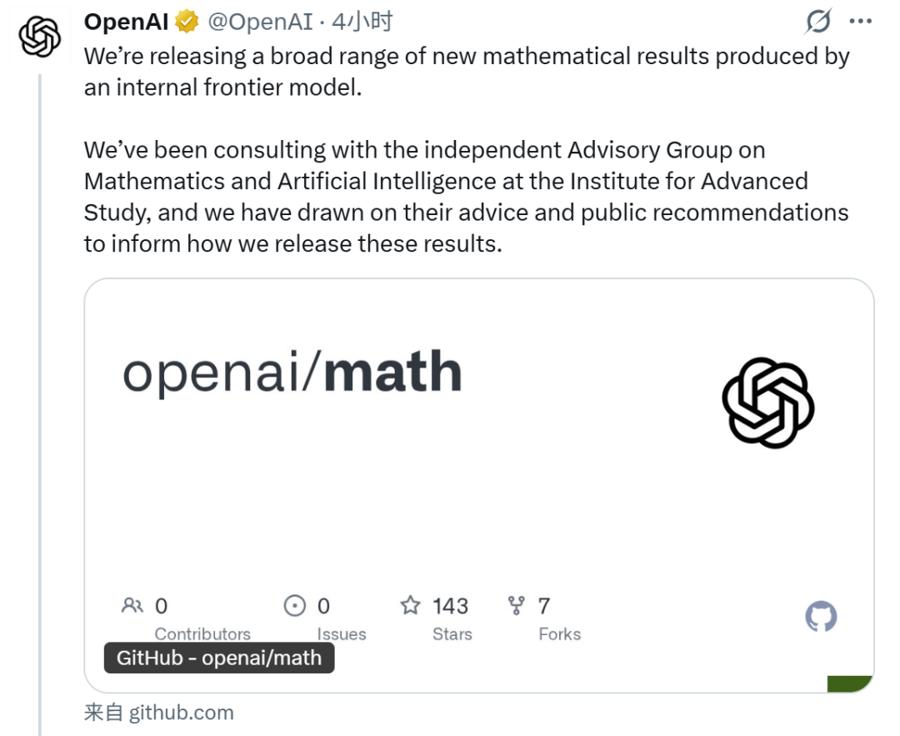
OpenAI一次性开源了722篇数学成果。
刚刚过去的9月,“踩刹车”一度成为AI行业的热词。
9月12日,美国人工智能公司Anthropic(安特罗匹克)公开呼吁全行业放慢模型迭代,并警告如果缺乏必要防护,AI智能体集群可能在未来6至12个月内出现失控风险。OpenAI也一度调整了最新模型的发布计划。
然而,警告犹在耳旁,竞赛却依然继续。
几乎同一时间,OpenAI发布700多篇数学成果,Anthropic和谷歌也相继推出新模型。今年,美国AI基础设施支出预计将超过7000亿美元,同比增长70%以上,由此可见,AI行业仍在加速竞争。
为什么人人都说应该慢下来,却没有谁敢真正放慢脚步?这正是典型的“囚徒困境”。
当前,AI领域尚未形成绝对领先的技术壁垒。谁率先踩下刹车,谁就可能让出下一轮技术竞争的主动权。虽然大家都看得见风险,但没人愿意成为第一个停下来的人。
那么,AI到底该不该放缓?该放缓的,从来不是技术进步,而是缺乏约束的“裸奔”。
一个容易被忽略的细节是,OpenAI承认这批数学成果中,仍有部分证明未经严格检验。试想,连数学这种最讲究对错、最容易验证的领域,都开始流行“先发布、后检查”,那么对于直接进入医疗、金融等高敏感的AI行业,又如何赢得公众信任?
答案不能只是依赖企业自律,而应当把“刹车”装进制度中。
首先,独立第三方安全评估,应当成为前沿模型上线前的必要步骤。其次,全球应探索建立可核查的协调机制,尽可能降低“单方面放缓”带来的竞争压力。最关键的是,要明确大模型发布者的验证义务和追责责任,坚持“谁开发谁验证,谁发布谁负责”。
722篇数学成果表明,AI在部分领域的发展,正在超越人类的运算极限。
越是在这样的关键节点,越不能把技术发展与安全治理对立起来。我们不是要求AI放缓进步,而是要确保每一次进步都在人类可以理解、验证和约束的范围之内。
(文章来源:上观新闻)




