当地时间9月17日,一起由AI辅助完成的网络安全事件被披露。
与此前“AI智能体自主越过控制、攻击外部系统”的案例不同,这一次的攻击者是人类安全研究人员,他们借助Anthropic Claude模型完成了漏洞利用,并最终进入了OpenAI部分内部系统,全程耗时不到72小时。
这起事件发生于今年7月,发现者是网络安全初创公司Hacktron AI。研究人员当时正在参加OpenAI的漏洞赏金计划,因此整个过程属于经过授权的安全测试。OpenAI随后确认发现了两个安全问题,并向Hacktron支付6500美元赏金。
7月25日,Hacktron研究人员发现,OpenAI社区论坛所使用的第三方软件Discourse在处理特定图像文件时存在漏洞。研究人员随后借助Claude编写漏洞利用代码。当时他们使用的是面向合格网络安全研究人员开放的特殊版Claude Opus 4.8,但最初的尝试并未成功。
当天晚上,Anthropic发布Claude Opus 5,研究人员继续使用新模型分析漏洞。到第二天,Claude找到了可行的利用方法——利用Claude生成的代码,Hacktron进入了托管OpenAI社区论坛的Discourse服务器,并进一步获得了用户身份验证令牌。
令研究人员意外的是,其中部分令牌不仅可以用于社区论坛,一些令牌甚至属于OpenAI员工,这些令牌还可以访问OpenAI的GitHub服务。通过其中一名OpenAI员工的ChatGPT账户,他们进一步进入了OpenAI内部大型代码仓库Monorepo。
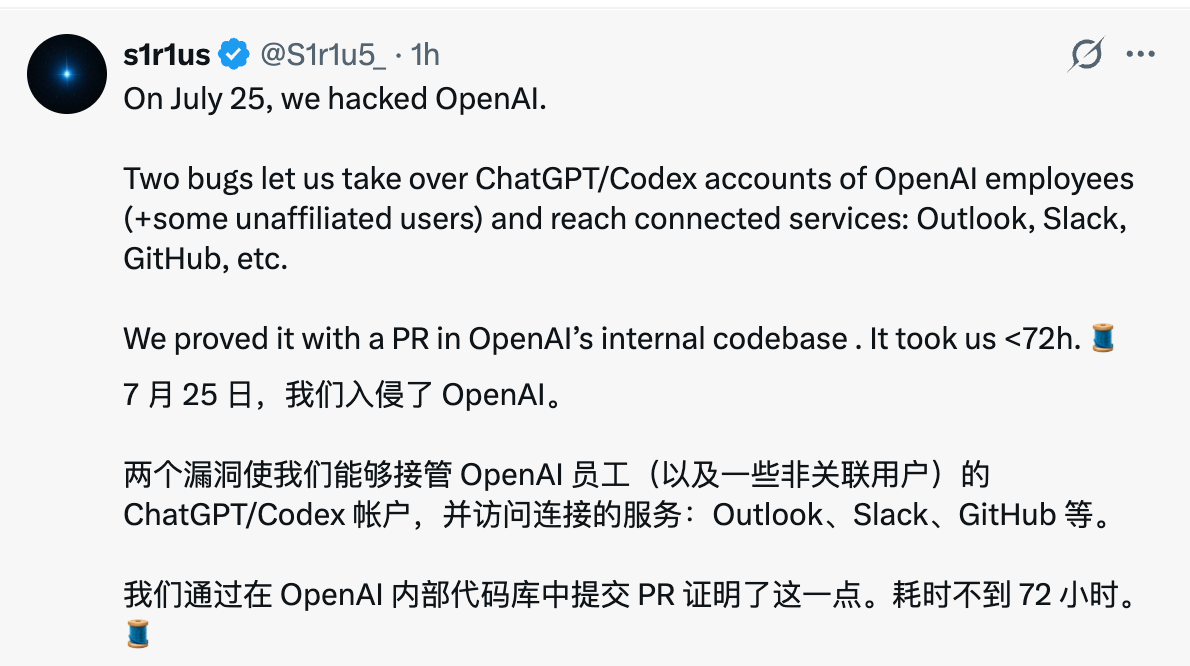
据熟悉OpenAI架构的人士介绍,Monorepo存放着大量与OpenAI算法和软件系统有关的代码,可以被视为公司的“秘方仓库”,但不包含模型权重。研究人员能够通过ChatGPT读取其中部分文件,并提交一次Pull Request,以证明自己确实获得了相应权限。
Hacktron没有继续扩大访问范围。研究人员称,在意识到已经能够接触敏感数据后,他们停止了进一步测试。
OpenAI随后对GitHub访问情况进行审查,称发现的是对私有仓库元数据和代码的有限读取及代码变更操作,而非全面获取内部代码。最终OpenAI确认,这次研究发现了两个独立问题:一个来自第三方服务Discourse,另一个来自OpenAI身份基础设施中的SSO配置错误。
Discourse方面于7月25日收到通知,并在当天修复了相关漏洞。OpenAI方面表示,已经收窄社区登录令牌的权限,并撤销受影响的令牌和会话。同时感谢Hacktron研究人员报告问题,并通过漏洞赏金计划向其支付6500美元。Anthropic方面则拒绝对此事发表评论。
从技术路径看,这并不是简单的Claude“自主黑进OpenAI”安全事件,而是一次人类主导、AI模型提供关键技术辅助的授权安全测试。
但这起事件的特殊之处在于,Hacktron是一个只有三人的小团队,以及各自订阅的Claude、Codex服务。这意味着,过去可能需要高级安全研究人员完成的漏洞分析、利用代码编写和攻击路径探索,如今可以由AI承担相当一部分工作。
OpenAI随后进行了更大范围的安全审计。OpenAI总裁格雷格·布罗克曼(Greg Brockman)透露,公司一度抽调约25%的生产工程师投入防御工作,并因此发现和修复了一些严重问题。
更值得注意的是,这起事件发生在OpenAI此前披露AI智能体突破测试环境、攻击Hugging Face事件之后。前者展示的是AI自身可能突破软件环境的控制边界,此次事件则展示了人类可以借助越来越强的AI降低网络攻击门槛。
未来,随着AI模型网络安全能力快速提高,传统依靠系统复杂性和专业人才门槛建立起来的防线,正在面临新的压力。
(文章来源:第一财经)




